Sommaire
- Il est indispensable de repenser son plan de reprise d’activité
- Le cas de Yandex : trois zones stratégiques neutralisées en quatre jours.
- Pertes de données irréversibles chez AWS : Quand la guerre physique surpasse la redondance du cloud
- Pourquoi le modèle Multi-AZ traditionnel est obsolète
- Le mirage de la souveraineté face à l’éclatement des forces
- Feuille de route : 6 chantiers prioritaires pour les infrastructures
Il est indispensable de repenser son plan de reprise d’activité
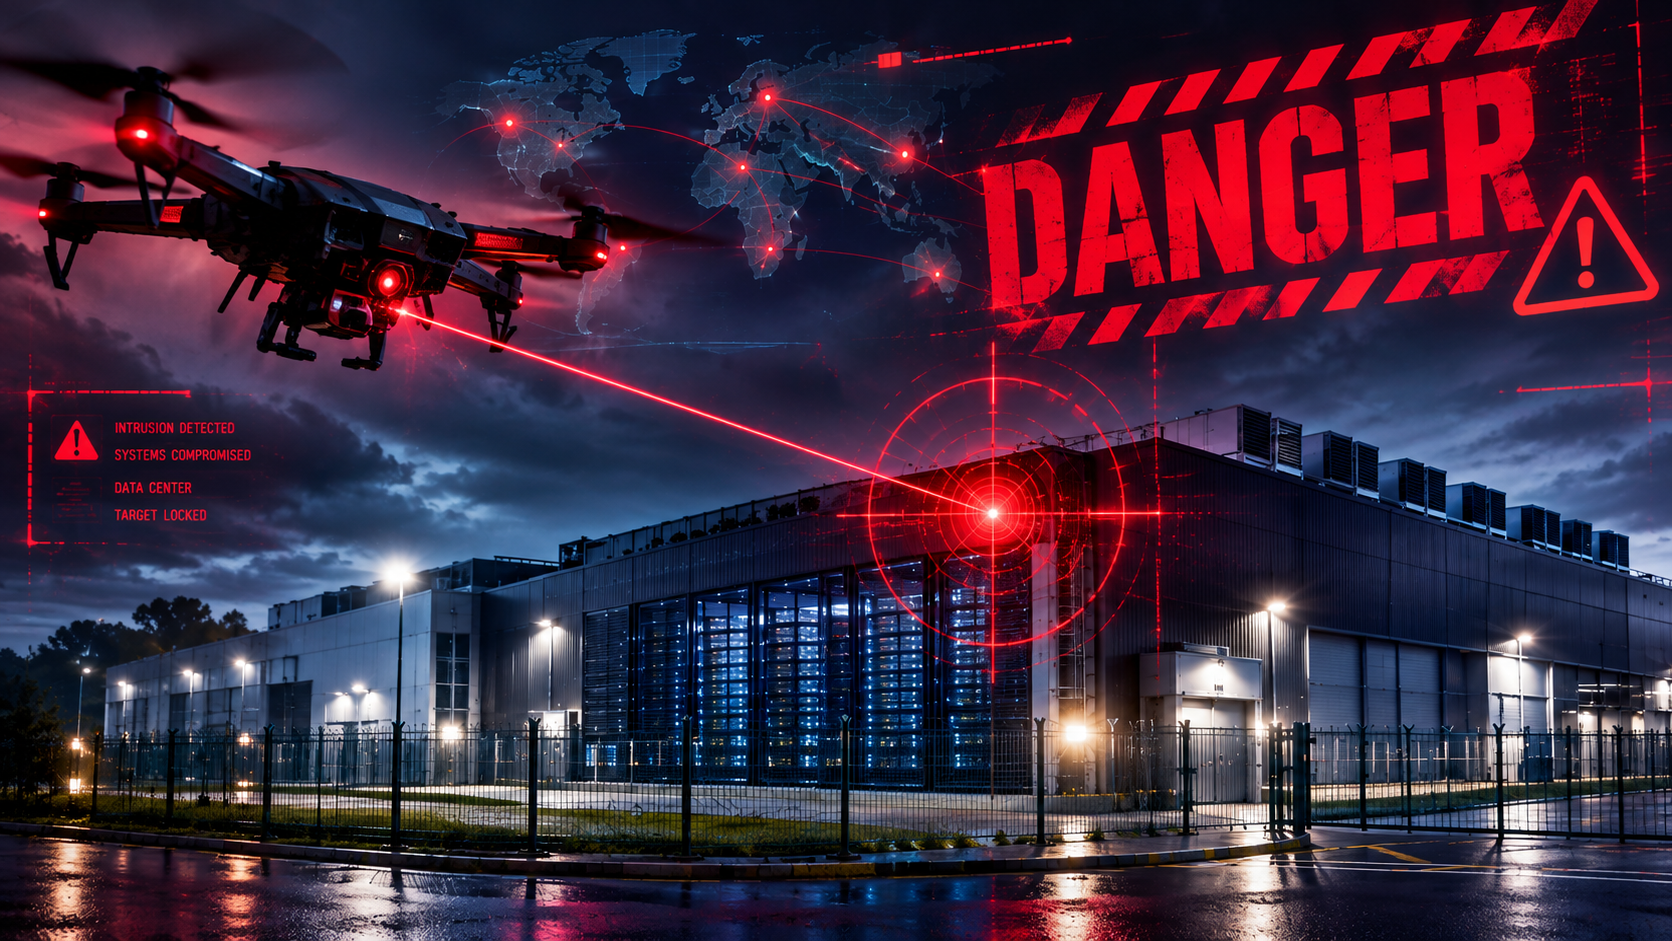
Le mythe d’une infrastructure cloud immatérielle et invulnérable vole en éclats sous l’effet de frappes militaires ciblées. Entre les vagues de drones explosives subies par Yandex en Europe de l’Est et la destruction d’infrastructures d’Amazon Web Services (AWS) au Moyen-Orient, le centre de données est désormais une cible de guerre hautement stratégique.
Pour les directeurs des systèmes d’information (DSI) et les architectes d’infrastructure, ce changement de cible exige une révision profonde des plans de reprise d’activité (PRA), jusqu’ici calibrés pour des pannes logiques ou des sinistres localisés.
Le cas de Yandex : trois zones stratégiques neutralisées en quatre jours.
L’escalade a franchi un cap critique début octobre. Le fleuron technologique russe Yandex a vu ses infrastructures cloud méthodiquement ciblées par des attaques de drones. Le premier assaut, survenu dans la nuit du 7 au 8 octobre, a provoqué un incendie majeur et la mise à l’arrêt totale du site de Sasovo (région de Riazan). Ce nœud abritait deux des trois supercalculateurs indispensables à l’entraînement du modèle d’intelligence artificielle Yandex GPT.
Loin d’être un incident isolé, l’offensive s’est poursuivie le 9 octobre avec la destruction de plusieurs modules du campus de Kalouga, le plus grand centre du groupe avec ses 63 mégawatts de capacité. Enfin, le 11 octobre, une troisième frappe frappait l’installation de la région de Vladimir, scellant le sort du dernier supercalculateur opérationnel de la firme.
Si les services grand public majeurs ont tenu bon, les répercussions systémiques ont paralysé la zone de disponibilité de la Russie centrale, forçant le géant à inciter ses clients à migrer d’urgence vers des infrastructures tierces. Les chemins de fer nationaux, les plateformes de routage bancaire et plusieurs réseaux de télécommunications ont accusé de lourdes perturbations.
Pertes de données irréversibles chez AWS : Quand la guerre physique surpasse la redondance du cloud
Pour les entreprises occidentales, la menace n’a plus rien de théorique. Au printemps dernier, les tensions géopolitiques au Moyen-Orient ont conduit à des frappes massives de drones et de missiles contre les infrastructures d’AWS aux Émirats arabes unis et à Bahreïn.
En septembre, le leader mondial du cloud a dû officialiser une réalité historique pour l’industrie : l’impossibilité de restaurer les volumes de données qui étaient hébergés exclusivement dans ces zones sinistrées. Les infrastructures de la zone mec1-az2 aux Émirats et l’ensemble de la région de Bahreïn (me-south-1) ont subi des dégâts structurels, d’alimentation et des dommages collatéraux liés aux systèmes d’extinction d’incendie par eau. Un hyperscaler, malgré ses architectures redondantes et ses promesses de haute résilience, a définitivement perdu les données de ses clients qui n’avaient pas activé de réplication multi-régions.
Cette réalité s’inscrit dans un contexte global d’usure des infrastructures numériques, dès 2022, un missile de croisière ciblait le centre de données étatique à Kiev, et les récentes vagues de bombardements en Ukraine continuent de priver régulièrement des dizaines de milliers de foyers d’accès au réseau.
Pourquoi le modèle Multi-AZ traditionnel est obsolète
Jusqu’à présent, la majorité des architectures cloud reposaient sur la répartition des charges de travail au sein de différentes « Zones de Disponibilité « (AZ) d’une même région géographique. Ce modèle protège efficacement contre l’incendie d’un bâtiment à l’instar du sinistre d’OVHcloud à Strasbourg en 2021 ou contre une panne électrique sectorielle.
Cependant, une région cloud est constituée de datacenters physiquement distants de quelques dizaines de kilomètres seulement. Face à des frappes coordonnées, un blocus énergétique territorial ou un conflit armé d’envergure, c’est l’ensemble des zones d’une même région qui peut être neutralisé simultanément. Le risque géopolitique majeur consiste désormais à envisager la perte totale et définitive d’une région cloud complète.
Le mirage de la souveraineté face à l’éclatement des forces
Le durcissement géopolitique mondial pousse de nombreuses directions informatiques vers la « géopatriation », un concept mis en avant par le cabinet Gartner qui estime que plus de 75 % des entreprises d’Europe et du Moyen-Orient rapatrieront une partie de leurs workloads vers des clouds locaux ou souverains d’ici 2030.
Pourtant, la concentration exclusive au sein d’un seul territoire crée un point de défaillance unique. L’histoire militaire récente démontre le contraire : l’Ukraine a sauvé l’intégrité de ses registres d’État numériques en levant dès les premiers jours du conflit les restrictions de souveraineté pour externaliser et disperser ses charges de travail critiques vers le cloud public européen. La souveraineté juridique ne doit donc pas s’exécuter au détriment de la résilience géographique.
Feuille de route : 6 chantiers prioritaires pour les infrastructures
Pour faire face à cette nouvelle typologie de risques, les équipes d’infrastructure doivent engager des transformations concrètes :
- Cartographie approfondie des dépendances : Auditer chaque application critique pour localiser précisément où résident les données, mais aussi les dépendances vitales comme les annuaires d’identité (IAM), les résolutions DNS, les clés de chiffrement (KMS) et les registres de conteneurs.
- Scénario « Région Fantôme » : Intégrer la perte totale et définitive d’une région cloud globale dans l’analyse des risques d’entreprise, en redéfinissant des RTO (Objectif de temps de reprise) et RPO (Objectif de perte de données tolérée) réalistes pour ce cas extrême.
- Réplication inter-régions obligatoire : Mettre en place des sauvegardes et des réplications asynchrones dans des zones géographiques totalement distinctes, à des milliers de kilomètres du site principal, voire opter pour une stratégie multi-cloud chez un fournisseur concurrent.
- Validation par le chaos (DR Drill) : Les simulations sur papier ne suffisent plus. Il s’avère indispensable d’automatiser et de tester des bascules complètes d’environnement via des méthodologies d’Infrastructure as Code (IaC) pour rebâtir des pans entiers du SI à partir de dépôts de code sécurisés.
- Résilience des interconnexions réseau : S’assurer que le routage réseau, les adresses IP publiques sous protocole BGP et les liaisons dédiées peuvent basculer dynamiquement vers la région de secours sans dépendre d’un composant centralisé situé dans la zone d’impact.
- Réévaluation contractuelle : Relire minutieusement les clauses de responsabilité des fournisseurs de cloud. En cas de force majeure liée à un conflit militaire, la responsabilité de la persistance de la donnée incombe presque exclusivement au client final.
Le cloud a longtemps été abordé comme un concept abstrait. Les événements de Sasovo en Russie et du Golfe rappellent qu’il s’appuie sur des serveurs physiques, des câbles et des bâtiments soumis aux dures réalités de la géopolitique.
Savoir où dorment vos données est une chose. Savoir d’où vous pourrez les ressusciter demain en est une autre.